 thigiacmay.com
Một nhà máy dập kim loại thuê làm hệ kiểm tra vết xước bằng học sâu. Bản demo trên 200 ảnh chụp ở văn phòng đạt độ chính xác rất cao. Lắp ra dây chuyền, hệ thống báo lỗi liên tục vào buổi chiều. Nguyên nhân: ánh nắng qua cửa sổ tạo vệt sáng trên bề mặt kim loại, thứ mà bộ ảnh huấn luyện chưa từng có.
Học sâu (deep learning) giải được những lỗi bề mặt mà thuật toán truyền thống bó tay: vết xước mờ trên kim loại xước sẵn, vết nhăn trên vải, vết lõm trên nhựa có vân. Nhưng học sâu kiểm tra lỗi bề mặt không phải là "mua phần mềm AI rồi cho chạy". Thành bại nằm ở ba chỗ: chọn đúng phương pháp, có bộ ảnh đại diện cho điều kiện thật, và đặt đúng máy tính cho từng khâu.
Bài này đi qua cả ba, dùng tài liệu của MVTec (hãng phần mềm thị giác máy HALCON) cho phần phương pháp và datasheet Advantech cho phần máy tính.
Khi nào cần học sâu, khi nào không?
Nếu lỗi định nghĩa được bằng luật đo đạc, như "lỗ đường kính nhỏ hơn 5 mm", "nhãn lệch quá 2 mm", "thiếu linh kiện ở vị trí X", thuật toán truyền thống nhanh hơn, rẻ hơn, dễ giải thích hơn. Học sâu đáng dùng khi lỗi khó mô tả bằng luật: hình dạng lỗi thay đổi, nền có vân tự nhiên, lỗi và vân nền trông gần giống nhau. Nhiều hệ tốt dùng cả hai: thuật toán truyền thống định vị và đo, học sâu phán lỗi bề mặt. Nền tảng về hai hướng này có trong bài sự khác biệt giữa thị giác máy và học máy.
Chọn phương pháp: không phải lúc nào cũng cần ảnh lỗi
MVTec liệt kê nhiều phương pháp học sâu trong thị giác máy: phân loại ảnh, phân vùng ngữ nghĩa, phát hiện đối tượng, phân vùng đối tượng, trích biên, đếm, OCR, và phát hiện bất thường. Với lỗi bề mặt, ba phương pháp hay dùng nhất:
| Phương pháp | Kết quả | Dữ liệu huấn luyện | Hợp khi |
|---|---|---|---|
| Phát hiện bất thường (anomaly detection) | Ảnh có bất thường không, vùng nào | Chỉ cần ảnh sản phẩm tốt, không gán nhãn | Lỗi hiếm, đa dạng, khó gom đủ mẫu lỗi |
| Phân loại (classification) | Ảnh thuộc loại nào (tốt, xước, lõm…) | Ảnh của từng loại, gán nhãn cả ảnh | Cần biết loại lỗi để thống kê, phân hạng |
| Phân vùng ngữ nghĩa (semantic segmentation) | Từng điểm ảnh thuộc lỗi nào | Ảnh lỗi được tô vùng lỗi từng điểm ảnh | Cần đo kích thước, diện tích lỗi |
Theo MVTec, phát hiện bất thường không cần gán nhãn thủ công: mô hình học đặc điểm của ảnh không lỗi rồi báo những vùng khác thường, và chỉ cần số lượng nhỏ ảnh tốt để huấn luyện. Hãng còn giới thiệu biến thể "global context anomaly detection" xét nội dung logic của cả ảnh, phát hiện được cả lỗi kiểu thiếu linh kiện, chi tiết biến dạng, đặt sai vị trí, cũng chỉ huấn luyện bằng ảnh tốt.
Đây là điểm xuất phát thực tế cho nhà máy: sản phẩm tốt thì có nhiều, sản phẩm lỗi thì hiếm và mỗi lỗi một kiểu. Bắt đầu bằng phát hiện bất thường để sàng lọc, gom ảnh lỗi thật trong quá trình chạy, rồi mới huấn luyện phân loại hay phân vùng khi đã có đủ mẫu.
Để thấy quy mô một bộ dữ liệu chuẩn: bộ MVTec AD mà giới nghiên cứu dùng để so sánh các phương pháp có hơn 5.000 ảnh độ phân giải cao chia thành 15 loại vật thể và bề mặt, mỗi loại có ảnh không lỗi để huấn luyện và bộ ảnh kiểm tra có lỗi với chú thích chính xác từng điểm ảnh. Lưu ý giấy phép của bộ này là CC BY-NC-SA 4.0, không được dùng cho mục đích thương mại; dự án nhà máy phải dùng ảnh của chính mình.
Dữ liệu: phần tốn công nhất
Ảnh phải đại diện cho điều kiện thật
Bộ ảnh huấn luyện phải chụp trên chính trạm kiểm tra, với chính camera, ống kính, đèn sẽ dùng khi chạy, và trải qua mọi điều kiện: các ca làm việc, các lô nguyên liệu, lúc máy mới vệ sinh và lúc bụi bám, sáng và chiều nếu có ánh sáng môi trường lọt vào. Trường hợp ở đầu bài là thiếu đúng điều kiện "buổi chiều có nắng".
Cố định ánh sáng trước khi gom ảnh
Mô hình học sâu học cả những gì không nên học: độ sáng, bóng đổ, vệt phản xạ. Đổi đèn hay đổi góc chiếu sau khi đã huấn luyện thường phải gom ảnh và huấn luyện lại. Vì vậy phần chiếu sáng và che chắn ánh sáng ngoài phải làm xong và khoá lại trước.
Gán nhãn nhất quán
Với phân loại và phân vùng, người gán nhãn phải thống nhất định nghĩa: vết xước dài bao nhiêu thì tính là lỗi, vết bẩn lau được có tính không. Hai người gán nhãn khác nhau cho cùng một ảnh là mô hình học mâu thuẫn. Nên viết một tài liệu định nghĩa lỗi có ảnh mẫu, do bộ phận chất lượng duyệt, trước khi gán nhãn.
Tách bộ ảnh kiểm tra
Giữ riêng một phần ảnh không dùng để huấn luyện, chụp ở thời điểm khác, để đánh giá mô hình. Đánh giá trên chính ảnh đã huấn luyện cho kết quả đẹp nhưng vô nghĩa.
Máy tính: tách máy huấn luyện khỏi máy chạy tại dây chuyền
Huấn luyện và chạy mô hình (suy luận, inference) là hai tải việc khác nhau, nên thường dùng hai loại máy.
Máy huấn luyện: GPU lớn, đặt ở phòng kỹ thuật
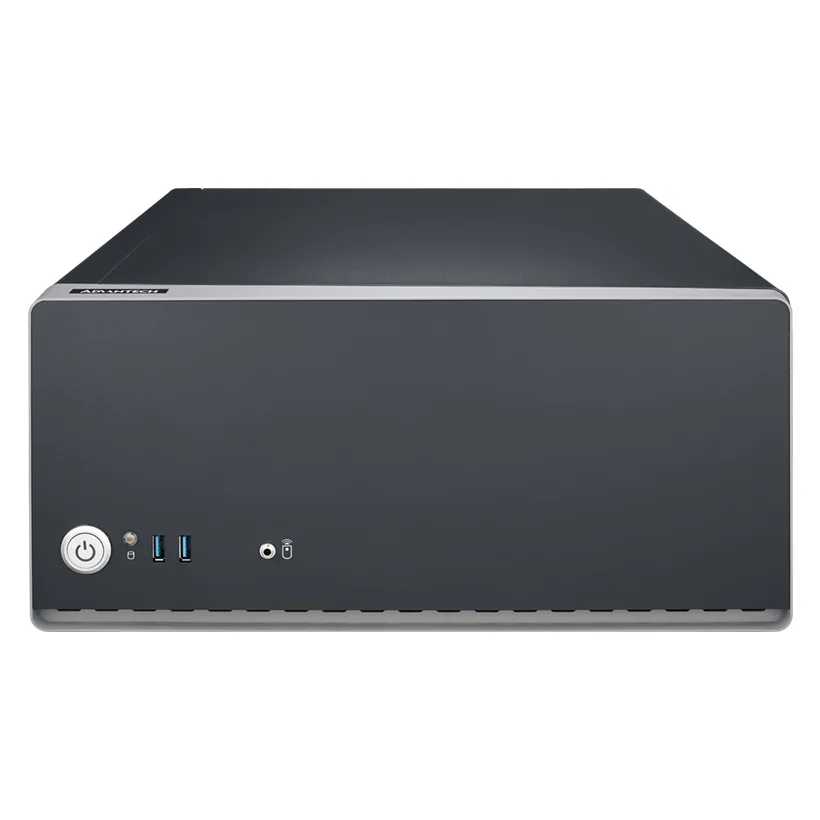
Datasheet Advantech AIR-510 ghi: CPU Intel Core thế hệ 12 tới 14, bộ nhớ DDR5 tới 192 GB, lắp được 1 card đồ hoạ 350 W cộng 2 card PCIe khác, được NVIDIA chứng nhận với RTX 6000 Ada, nguồn ATX 3.0 850 W tích hợp, 2 khoang ổ chống sốc chứa tới 8 SSD 2,5", mạng 1 GbE và 2.5 GbE.
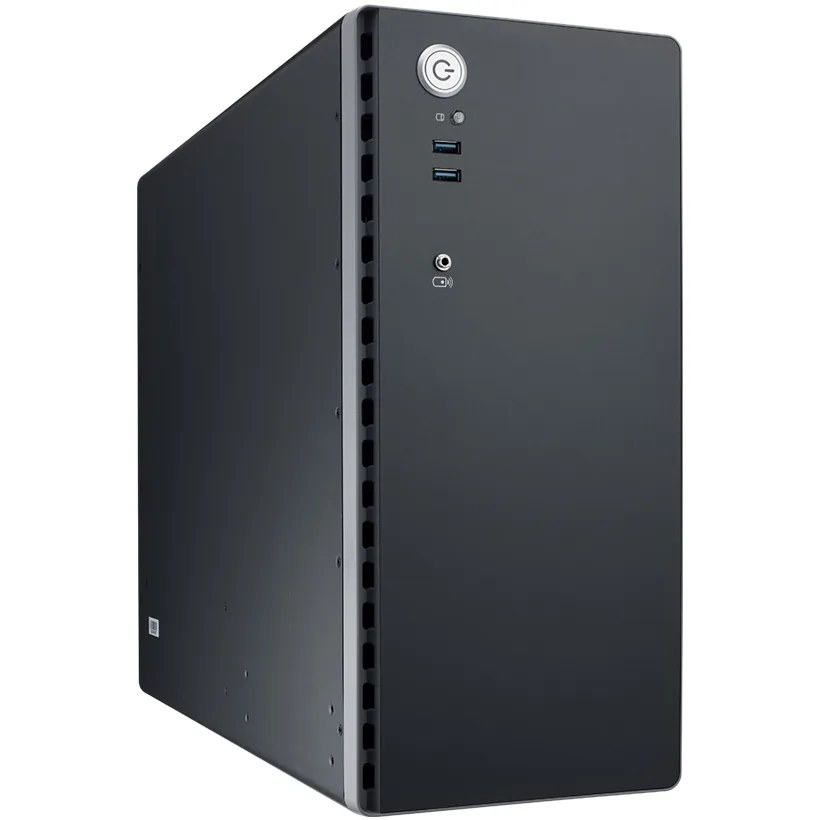
Dòng nhiệt độ của máy này là điểm cần đọc: 0 đến 40 °C khi chưa lắp card PCIe. Lắp card GPU 350 W vào thì nhiệt độ môi trường cho phép còn phụ thuộc card. Đây là máy cho phòng kỹ thuật có điều hoà, không phải máy đặt cạnh dây chuyền. Vai trò của nó: huấn luyện, thử mô hình mới, lưu toàn bộ kho ảnh.
Máy chạy tại dây chuyền: nhỏ, không quạt, chịu môi trường xưởng
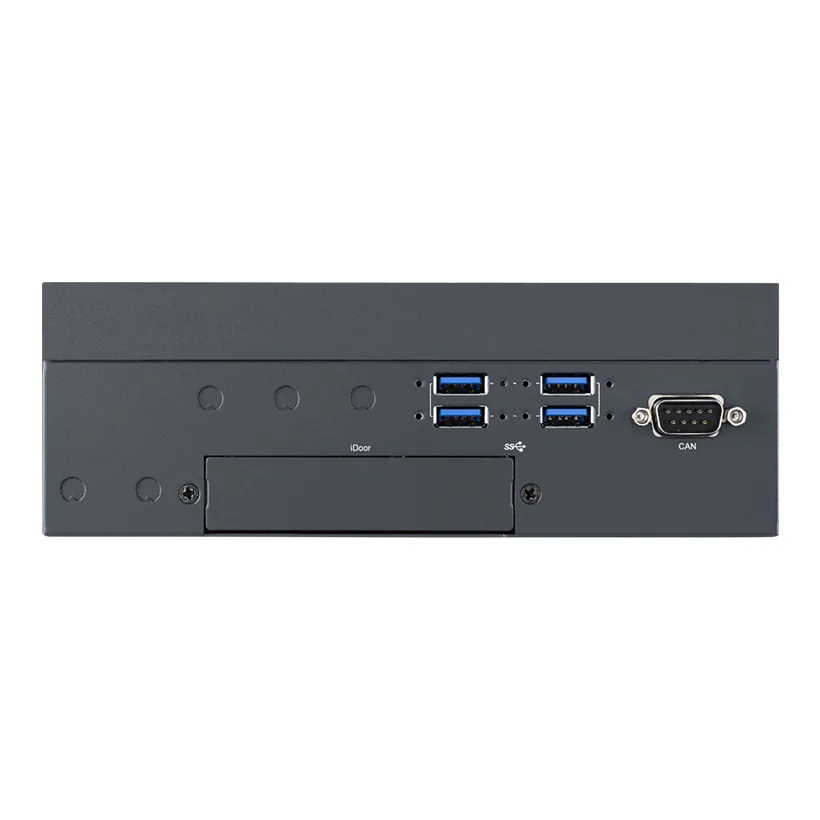
Mô hình đã huấn luyện được xuất ra và chạy trên máy nhỏ đặt cạnh trạm kiểm tra. Advantech MIC-713-ON là ví dụ: mô-đun NVIDIA Jetson Orin Nano tới 67 TOPS (chế độ Super), 2 cổng Gigabit Ethernet, 6 USB 3.2, 4 DI/4 DO để nhận trigger và trả kết quả đạt/không đạt, nguồn 9–36 VDC, rung 3 Grms. Nhiệt độ −10 đến 60 °C với gió 0,7 m/s, và −10 đến 50 °C ở chế độ hiệu năng cao nhất.
Nếu trạm có nhiều camera độ phân giải cao hoặc mô hình nặng, máy chạy tại dây chuyền cần GPU rời trong máy công nghiệp có khe PCIe, như trình bày trong bài máy tính cho hệ thống thị giác máy: PoE, băng thông và GPU. Nguyên tắc chung: đo thời gian suy luận thật của mô hình trên máy dự kiến, với độ phân giải thật, so với nhịp dây chuyền, trước khi mua số lượng.
Vận hành sau khi chạy: mô hình cũng cần bảo trì
- Lưu ảnh bị báo lỗi và ảnh sát ngưỡng, cho bộ phận chất lượng xem lại hằng tuần. Đây là nguồn ảnh để huấn luyện lại.
- Theo dõi tỷ lệ báo lỗi theo ca, theo lô. Tỷ lệ tăng đột ngột thường do điều kiện thay đổi (đèn yếu đi, ống kính bẩn, nguyên liệu mới), không phải do sản phẩm xấu đi.
- Quản lý phiên bản mô hình: mỗi lần huấn luyện lại ghi rõ bộ dữ liệu, kết quả đánh giá, ngày đưa vào dây chuyền, và giữ được bản cũ để quay lại.
Các ví dụ ứng dụng học sâu trong sản xuất có trong bài những ứng dụng của deep learning trong thực tiễn sản xuất; vai trò của thị giác máy trong kiểm tra chất lượng nói chung ở bài thị giác máy trong kiểm tra chất lượng.
Câu hỏi thường gặp
Cần bao nhiêu ảnh để bắt đầu?
MVTec không công bố con số cố định, chỉ nói phát hiện bất thường cần số lượng nhỏ ảnh tốt. Thực tế phụ thuộc độ biến thiên của sản phẩm tốt: bề mặt đồng đều cần ít, bề mặt có vân tự nhiên cần nhiều hơn. Cách làm an toàn là gom ảnh qua nhiều ca, nhiều lô, rồi thử huấn luyện và đánh giá trên bộ kiểm tra riêng.
Có huấn luyện trên máy tính tại dây chuyền được không?
Một số phần mềm cho phép huấn luyện mô hình nhỏ ngay trên máy tại chỗ. Nhưng tách hai máy giúp dây chuyền không bị ảnh hưởng khi thử nghiệm, và kho ảnh lớn nằm ở nơi an toàn, có sao lưu.
Mô hình báo lỗi nhầm nhiều thì sao?
Kiểm tra trước ánh sáng và độ sạch ống kính, sau đó xem ảnh báo nhầm có điểm chung gì (thời điểm, lô, vị trí). Thường là bộ ảnh huấn luyện thiếu một điều kiện có thật, cần bổ sung ảnh tốt của điều kiện đó.
IPC247 hỗ trợ gì
IPC247 phân phối máy tính GPU, máy tính AI nhúng và máy tính công nghiệp Advantech cho hệ thống thị giác máy. Chúng tôi tư vấn cấu hình máy huấn luyện và máy chạy tại dây chuyền theo mô hình, số camera và nhịp sản xuất, cho mượn máy để đo thời gian suy luận thật, giao hàng và hỗ trợ kỹ thuật khi triển khai. Gửi cho chúng tôi mô tả sản phẩm và lỗi cần kiểm để nhận đề xuất.


